Qwen3.8-27B 正式开源!虽然 Qwen3.8-27B 只有 270 亿参数,但是它不是一款普通的小型语言模型,而是一款原生多模态稠密模型,在编程、办公、视觉理解以及 Agent 工作流等真实应用场景中,都展现出了相当强的综合能力的模型。今天我们在国产DeepSeek Harness中部署8GB 显存版。
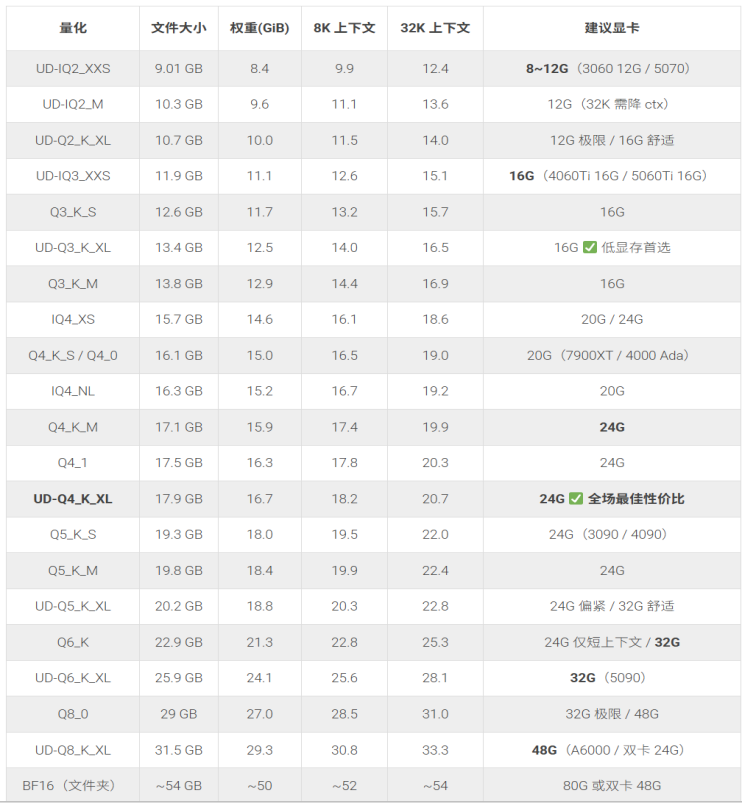
第一步,下载Qwen3.8-27B 开源模型
1、Huggingface 下载:https://hf-mirror.com/unsloth/Qwen3.8-27B-GGUF/tree/main
第二步,下载llama.cpp一键安装包
llama.cpp是在本地,以最小的设置和最先进的性能,在各种硬件上实现 LLM(和 VLM)推理。
纯 C/C++ 实现,没有任何依赖项
苹果芯片是一等公民——通过 ARM NEON、Accelerate 和 Metal 框架进行了优化。
支持 x86 架构的 AVX、AVX2、AVX512 和 AMX 指令集
对 RISC-V 架构的 RVV、ZVFH、ZFH、ZICBOP 和 ZIHINTPAUSE 支持
支持 1.5 位、2 位、3 位、4 位、5 位、6 位和 8 位整数量化,以加快推理速度并减少内存占用。
用于在 NVIDIA GPU 上运行 LLM 的自定义 CUDA 内核(通过 HIP 支持 AMD GPU,通过 MUSA 支持 Moore Threads GPU)
Vulkan 和 SYCL 后端支持
利用 CPU+GPU 混合推理技术,部分加速大于总显存容量的模型。
接下载 llama.cpp的一键安装包
官网:https://huggingface.co/unsloth/Muse-Glimmer-30B-GGUF/tree/main(国内可以镜像网站下载)
夸克网盘:/~25253aFEkS~:/ 链接:https://pan.quark.cn/s/d7d6c2ba0e19 提取码:
xvGc
第二步,下载Qwen3.8-27B 解除封印版模型(国内镜像网站搜索模型名称)
https://huggingface.co/JonathanColetti/Qwen3.8-27B-Uncensored-GGUF
第四步,安装运行DeepSeek Harness(没安装环境的看DeepSeek Harness上期视频)1
(安装环境看上期视频)
在 PowerShell终端一行命令拉起黑鲸鱼:npx @deepseek-ai/dsh web。
第三步,划重点!在 Harness 的设置里选择 ‘OpenAI Compatible’。
第四步,Base URL 填入你本地跑 Muse-Glimmer 的服务地址,模型名称直接手写 Muse-Glimmer-30B。点击保存,你的‘缝合怪’智能体就已经诞生了!”